موسوعة عربية للمعرفة التقنية والعلمية الموثقة
ما هي البيانات المنظمة (Schema Markup)؟
خلاصة سريعة: البيانات المنظمة (Schema Markup) هي ترميز مضاف إلى صفحة الويب يشرح لمحركات البحث نوع المحتوى وعناصره: مقال، أو مؤسسة، أو سؤال شائع، أو منتج. تُكتب عادةً بـJSON-LD وفق قاموس schema.org، ولا تغيّر شكل الصفحة للقارئ، لكنها تساعد المحرك على فهمها وربطها بكيانات معروفة.
ما هي البيانات المنظمة (Schema Markup)؟
البيانات المنظمة لغة مشتركة بين صفحتك ومحركات البحث. فبدل أن يستنتج المحرك من النص أن هذه صفحة مقال، وأن صاحبها جهة معينة، وأن تاريخ نشرها محدد، تجد هذه المعلومات مكتوبة بصيغة يفهمها. والقاموس المستخدم هو schema.org، وهو مشروع مشترك بين Google وMicrosoft وYahoo وYandex، ويُحدّث بإصدارات دورية.
ولا تُعرض هذه البيانات للقارئ في متن الصفحة؛ فهي موجودة في كود HTML، بينما يرى الزائر العنوان والصورة والنص كما هي. ولهذا يخطئ من يظنها تنسيقًا مرئيًا، أو من يظنها بديلًا عن تحسين محركات البحث داخل الصفحة؛ فهي طبقة شرح فوق محتوى قائم، لا محتوى جديد.
لماذا تهم البيانات المنظمة؟
- فهم الكيانات: تساعد المحرك على التمييز بين شخص ومؤسسة ومقال، وعلى ربط الأسماء بمراجع معروفة.
- ميزات صفحة النتائج: قد تؤهل الصفحة لمقتطفات غنية داخل صفحة نتائج البحث، مثل مسار التنقل وتقييمات المقال، وهي ميزات لا تُضمن.
- الوضوح في البحث التوليدي: الأنظمة التي تلخص الإجابات تقرأ العلاقات بين الكاتب والناشر والتاريخ بسهولة أكبر.
- الاتساق: ترميز واضح يكشف التناقضات داخل الموقع، مثل تاريخ نشر مختلف في مكانين.
كيف تعمل البيانات المنظمة؟ JSON-LD خطوة بخطوة
الصيغة التي توصي بها Google هي JSON-LD، وهي كتلة نصية داخل وسم script من نوع application/ld+json. وتتكون من أربعة عناصر:
- السياق
@context: يحدد القاموس، ويكون عادةًhttps://schema.org. - النوع
@type: يحدد فئة الكيان، مثلArticleأوOrganization. - الخصائص: تصف الكيان، مثل العنوان والكاتب والتاريخ والصورة.
- العلاقات: تربط الكيانات ببعضها، مثل ربط المقال بمؤلفه وناشره عبر كائنات متداخلة أو معرّفات.
ويُستخدم sameAs لربط كيانك بمراجع خارجية، مثل صفحة المؤسسة في Wikidata أو حسابها الرسمي. هذا الربط يفيد في تمييز الاسم عن غيره، لكنه لا يمنح ثقة لم تكن موجودة، ولا يصلح بديلًا عن تحسين محركات البحث (SEO) الحقيقي.
أنواع البيانات المنظمة الشائعة
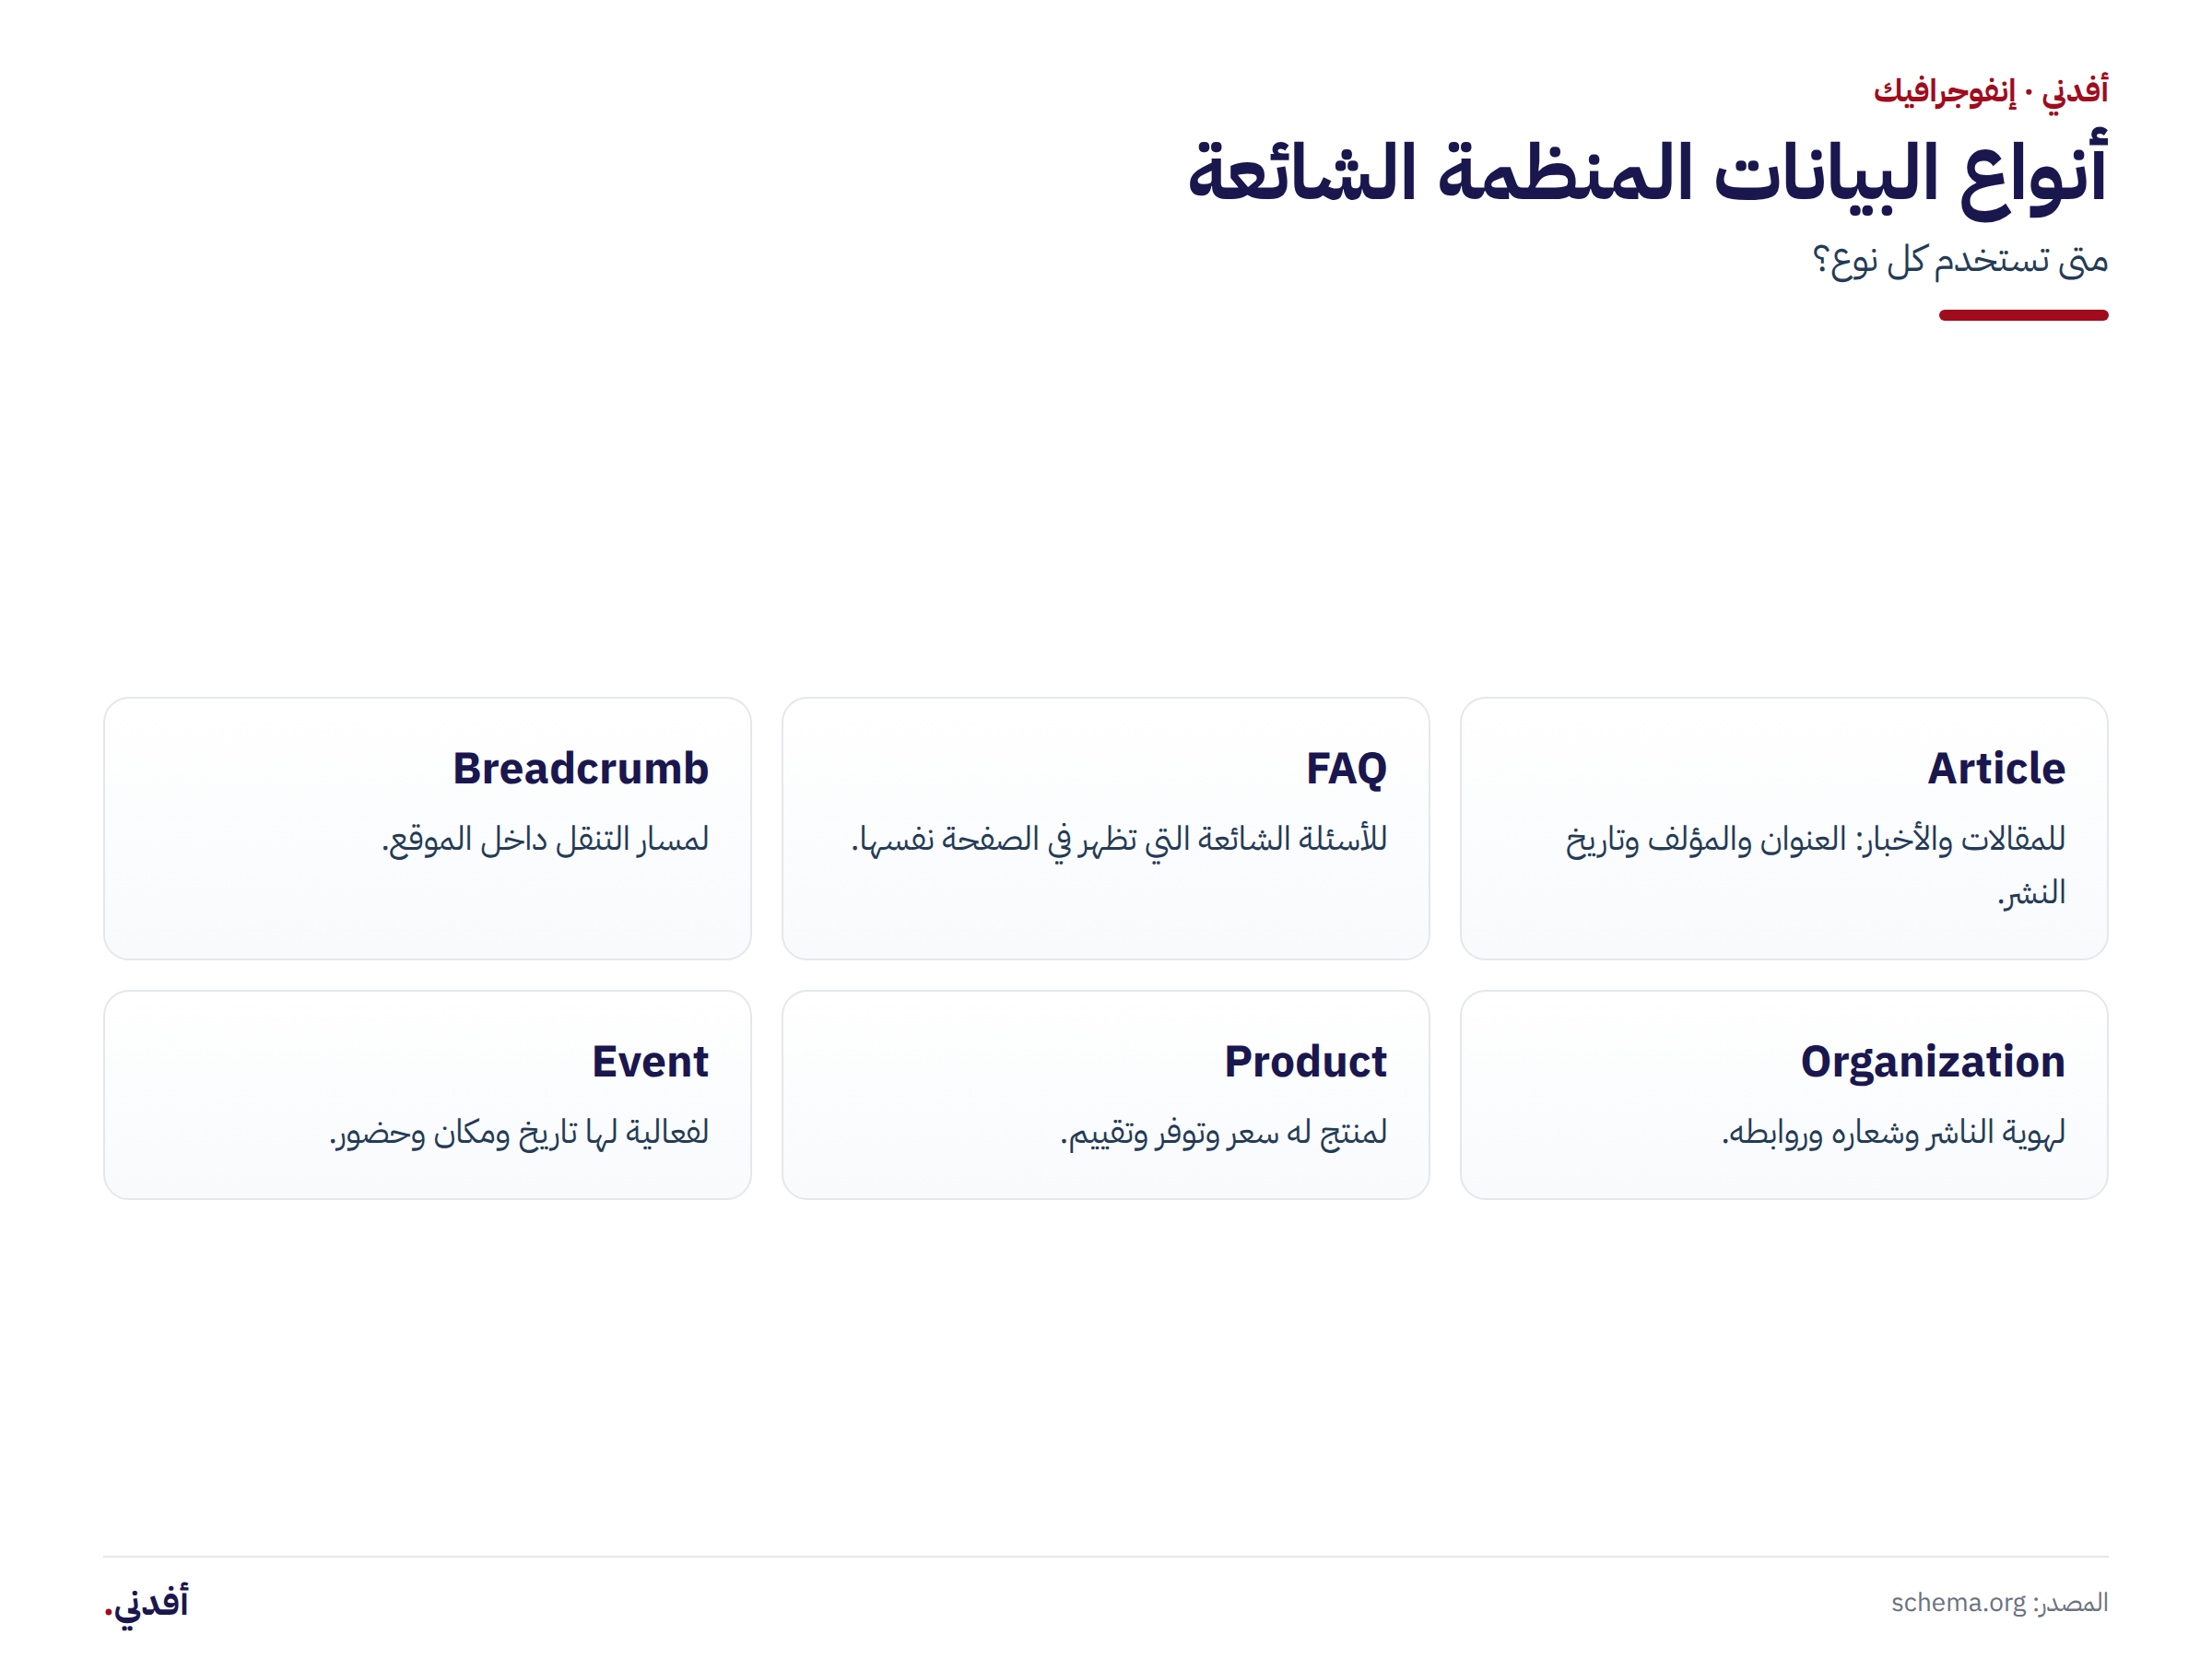
- Article: للمقالات والأخبار والتحليلات، ويشمل العنوان والكاتب وتاريخ النشر.
- BreadcrumbList: لمسار التنقل الذي يظهر بدل الرابط في نتائج البحث.
- Organization: لتعريف المؤسسة وشعارها ووسائل التواصل.
- WebSite: لتعريف الموقع، وقد يُستخدم مع خاصية البحث الداخلي.
- Person: لتعريف الكاتب، ويرتبط عادةً بصفحة سيرة مخصصة.
- FAQPage: لأسئلة وأجوبة الصفحة، مع ملاحظة أن نتائجها الغنية تقلصت.
- Product وEvent: للمنتجات والفعاليات، ولكل منهما خصائص إلزامية محددة.
ليست كل الأنواع متساوية في الأثر. فقد وسّعت Google دعم بعضها وقلّصت أخرى؛ فنتائج HowTo الغنية أُوقفت، ونتائج FAQ الغنية حُصرت في نطاق أضيق من المواقع الموثوقة. اقرأ صفحة النوع قبل تطبيقه، ولا تفترض أن الترميز سيغيّر شكل النتيجة تلقائيًا. ويجمع الشكل 1 الأنواع الستة الأكثر استخداماً.
مثال عملي على ترميز مقال
{
  "@context": "https://schema.org",
  "@type": "Article",
  "headline": "ما هي البيانات المنظمة؟",
  "datePublished": "2026-10-24",
  "dateModified": "2026-10-24",
  "author": { "@type": "Person", "name": "أفدني" },
  "publisher": { "@type": "Organization", "name": "أفدني" }
}
لاحظ أن القيم مطابقة لما في الصفحة: العنوان نفسه، والتاريخ نفسه، والاسم نفسه. وأي اختلاف بين الترميز والمحتوى المرئي يُضعف الثقة، وقد يُعدّ مخالفة إذا استُخدم لإظهار معلومات لا يراها القارئ.
كيف تتحقق من صحة الترميز؟
- افتح Rich Results Test لمعرفة الأنواع التي قد تؤهل الصفحة لميزة غنية.
- استخدم Schema Markup Validator لفحص الصحة النحوية والخصائص المطلوبة.
- راجع تقرير التحسينات في Search Console بعد النشر، لا قبله فقط.
- افحص الصفحة بعد تنفيذ JavaScript، لأن بعض القوالب تضيف الترميز بعد التحميل.
- احتفظ بنسخة من الترميز في المستودع، حتى لا يضيع عند تغيير القالب.
أخطاء شائعة في البيانات المنظمة
- عدم التطابق: ترميز يذكر تقييمًا أو سعرًا لا وجود له في الصفحة.
- حشو الكلمات المفتاحية: استخدام الخصائص لتكرار عبارات لا تخدم الفهم.
- كيانات وهمية: مؤسسة أو كاتب لا يمكن التحقق من وجوده.
- تكرار الأنواع: أكثر من كتلة Article متناقضة في الصفحة نفسها.
- الاعتماد على قوالب جاهزة: إضافات تُخرج أنواعًا لا تناسب نوع الصفحة.
- إهمال الصيانة: ترميز قديم بعد تغيير العنوان أو تاريخ التحديث.
حدود البيانات المنظمة
البيانات المنظمة تشرح ولا تُقنع. لا ترفع ترتيب صفحة ضعيفة، ولا تضمن ميزة غنية، ولا تعوّض محتوى ناقصًا. وقد تتجاهلها Google إن وجدت تناقضًا مع إشارات أخرى، أو إن كان النوع غير مدعوم. تعامل معها بوصفها جزءًا من بنية الموقع، تُراجع مع كل تحديث للمحتوى، لا حيلة تُضاف مرة واحدة.
ومن المفيد أيضًا التفريق بين الترميز وبين واجهات البرمجة. فالترميز يصف ما في الصفحة، بينما تُستخدم واجهات برمجة التطبيقات (APIs) لجلب البيانات من أنظمة أخرى. لا تحقن بيانات من واجهة خارجية في الترميز إن لم تكن ظاهرة للقارئ، لأن ذلك يخالف قاعدة التطابق.
ولاستكمال الصورة في بنية الظهور العضوي، راجع أيضًا شرح تحسين محركات البحث التقني ومعايير E-E-A-T والوصف التعريفي.
أسئلة شائعة عن البيانات المنظمة
هل البيانات المنظمة ترفع ترتيب الموقع؟
لا تعدّها Google عامل ترتيب مباشرًا. وظيفتها مساعدة المحرك على فهم المحتوى والكيانات، وقد تؤهل الصفحة لميزات غنية تزيد النقر. لا تضمن هذه الميزات، لأن المحرك يقرر متى يعرضها بحسب النوع والجودة والسياق.
ما الفرق بين JSON-LD وMicrodata؟
كلاهما صيغة لترميز البيانات، لكن JSON-LD يوضع في كتلة مستقلة داخل الصفحة، ولا يتشابك مع HTML المرئي، ولهذا توصي به Google ويسهل صيانته. أما Microdata فيُضاف إلى الوسوم نفسها، وقد يصعب تعديله عند تغيير التصميم. النتيجة المفهومة واحدة، والفرق في طريقة الكتابة والصيانة.
هل أحتاج ترميزًا لكل صفحة؟
لا تحتاج إلى ترميز في كل صفحة، بل في الصفحات التي يضيف فيها الترميز معنى: المقالات، وصفحات التعريف، ومسارات التنقل، والأسئلة الشائعة. ابدأ بالأنواع الأساسية التي تطابق محتواك، ثم وسّع بعد التحقق. الترميز الزائد بلا مضمون قد يزيد الأخطاء.
كيف أتحقق من صحة البيانات المنظمة؟
استخدم اختبار النتائج الغنية، ثم مدقق Schema Markup Validator لفحص الخصائص الإلزامية. بعد النشر، راقب تقرير التحسينات في Search Console. ولا تكتفِ بنجاح الأداة؛ قارن القيم بما هو ظاهر في الصفحة، لأن الخطأ الشائع هو بيانات صحيحة نحويًا ومخالفة للمحتوى.
هل تؤثر البيانات المنظمة في الظهور داخل إجابات الذكاء الاصطناعي؟
قد تساعد، لأنها تعرض العلاقات بوضوح: من كتب، ومن نشر، ومتى، وما نوع المحتوى. لكن الأنظمة التوليدية تعتمد أيضًا على النص نفسه وجودة المصدر وسمعته. الترميز يسهّل القراءة، ولا يضمن الاقتباس، ولا يعوّض غياب التجربة أو الدليل.
المصادر
- Introduction to structured data markup — Google Search Central، آخر تحديث 10 ديسمبر 2025.
- Article structured data — Google Search Central، آخر تحديث 8 سبتمبر 2026.
- FAQPage structured data — Google Search Central، آخر تحديث 23 أكتوبر 2026.
- Schema.org releases — الإصدار 30.1، 16 سبتمبر 2026.
- JSON-LD 1.1 — توصية W3C، 16 يوليو 2020.