موسوعة عربية للمعرفة التقنية والعلمية الموثقة
ما هو الزحف والفهرسة (Crawling & Indexing)؟
خلاصة سريعة: الزحف والفهرسة (Crawling & Indexing) مرحلتان متتاليتان: يكتشف الزاحف عنوان الصفحة ويطلبها ليقرأ محتواها، ثم يقرر محرك البحث هل يحفظها في فهرسه. الزحف لا يعني الظهور، والفهرسة لا تعني الترتيب؛ كل مرحلة شرط لما بعدها، ولا تختصر المرحلة التالية.
ما هو الزحف والفهرسة (Crawling & Indexing)؟
الزحف هو عملية اكتشاف الصفحات وطلبها من الخادم. يبدأ الزاحف من عنوان معروف، ثم يتبع الروابط، ويقرأ خريطة الموقع، ويطلب كل عنوان يجد أنه يستحق الزيارة. والفهرسة هي الخطوة التالية: تحليل ما وصل إليه الزاحف، ثم تخزين الصفحة في فهرس ضخم منظّم بحسب الموضوع واللغة والعلاقات.
المرحلتان منفصلتان، وهذا مصدر أكثر الالتباس في تحسين محركات البحث (SEO). فقد تُزحف صفحة ولا تُفهرس، أو تُفهرس ثم تُستبعد لاحقًا. ولهذا لا يكفي أن ترى زيارة من زاحف Google لتستنتج أن الصفحة في النتائج؛ تحتاج إلى تأكيد منفصل.
لماذا يهم الزحف والفهرسة؟
- شرط الظهور: الصفحة غير المفهرسة لا يمكن أن تظهر في صفحة نتائج البحث مهما كان محتواها.
- تحديد ما يُقرأ: ملفات التحكم تمنع صفحات الإدارة والبحث الداخلي من استهلاك جهد الزحف.
- سلامة المحتوى: وسم خاطئ واحد قد يخفي قسمًا كاملًا من الموقع.
- كفاءة الموارد: توجيه الزاحف إلى الصفحات المهمة يسرّع اكتشاف الجديد.
- تشخيص التقلبات: كثير من هبوط الزيارات يبدأ من تغير في الفهرسة لا من تغير في الترتيب.
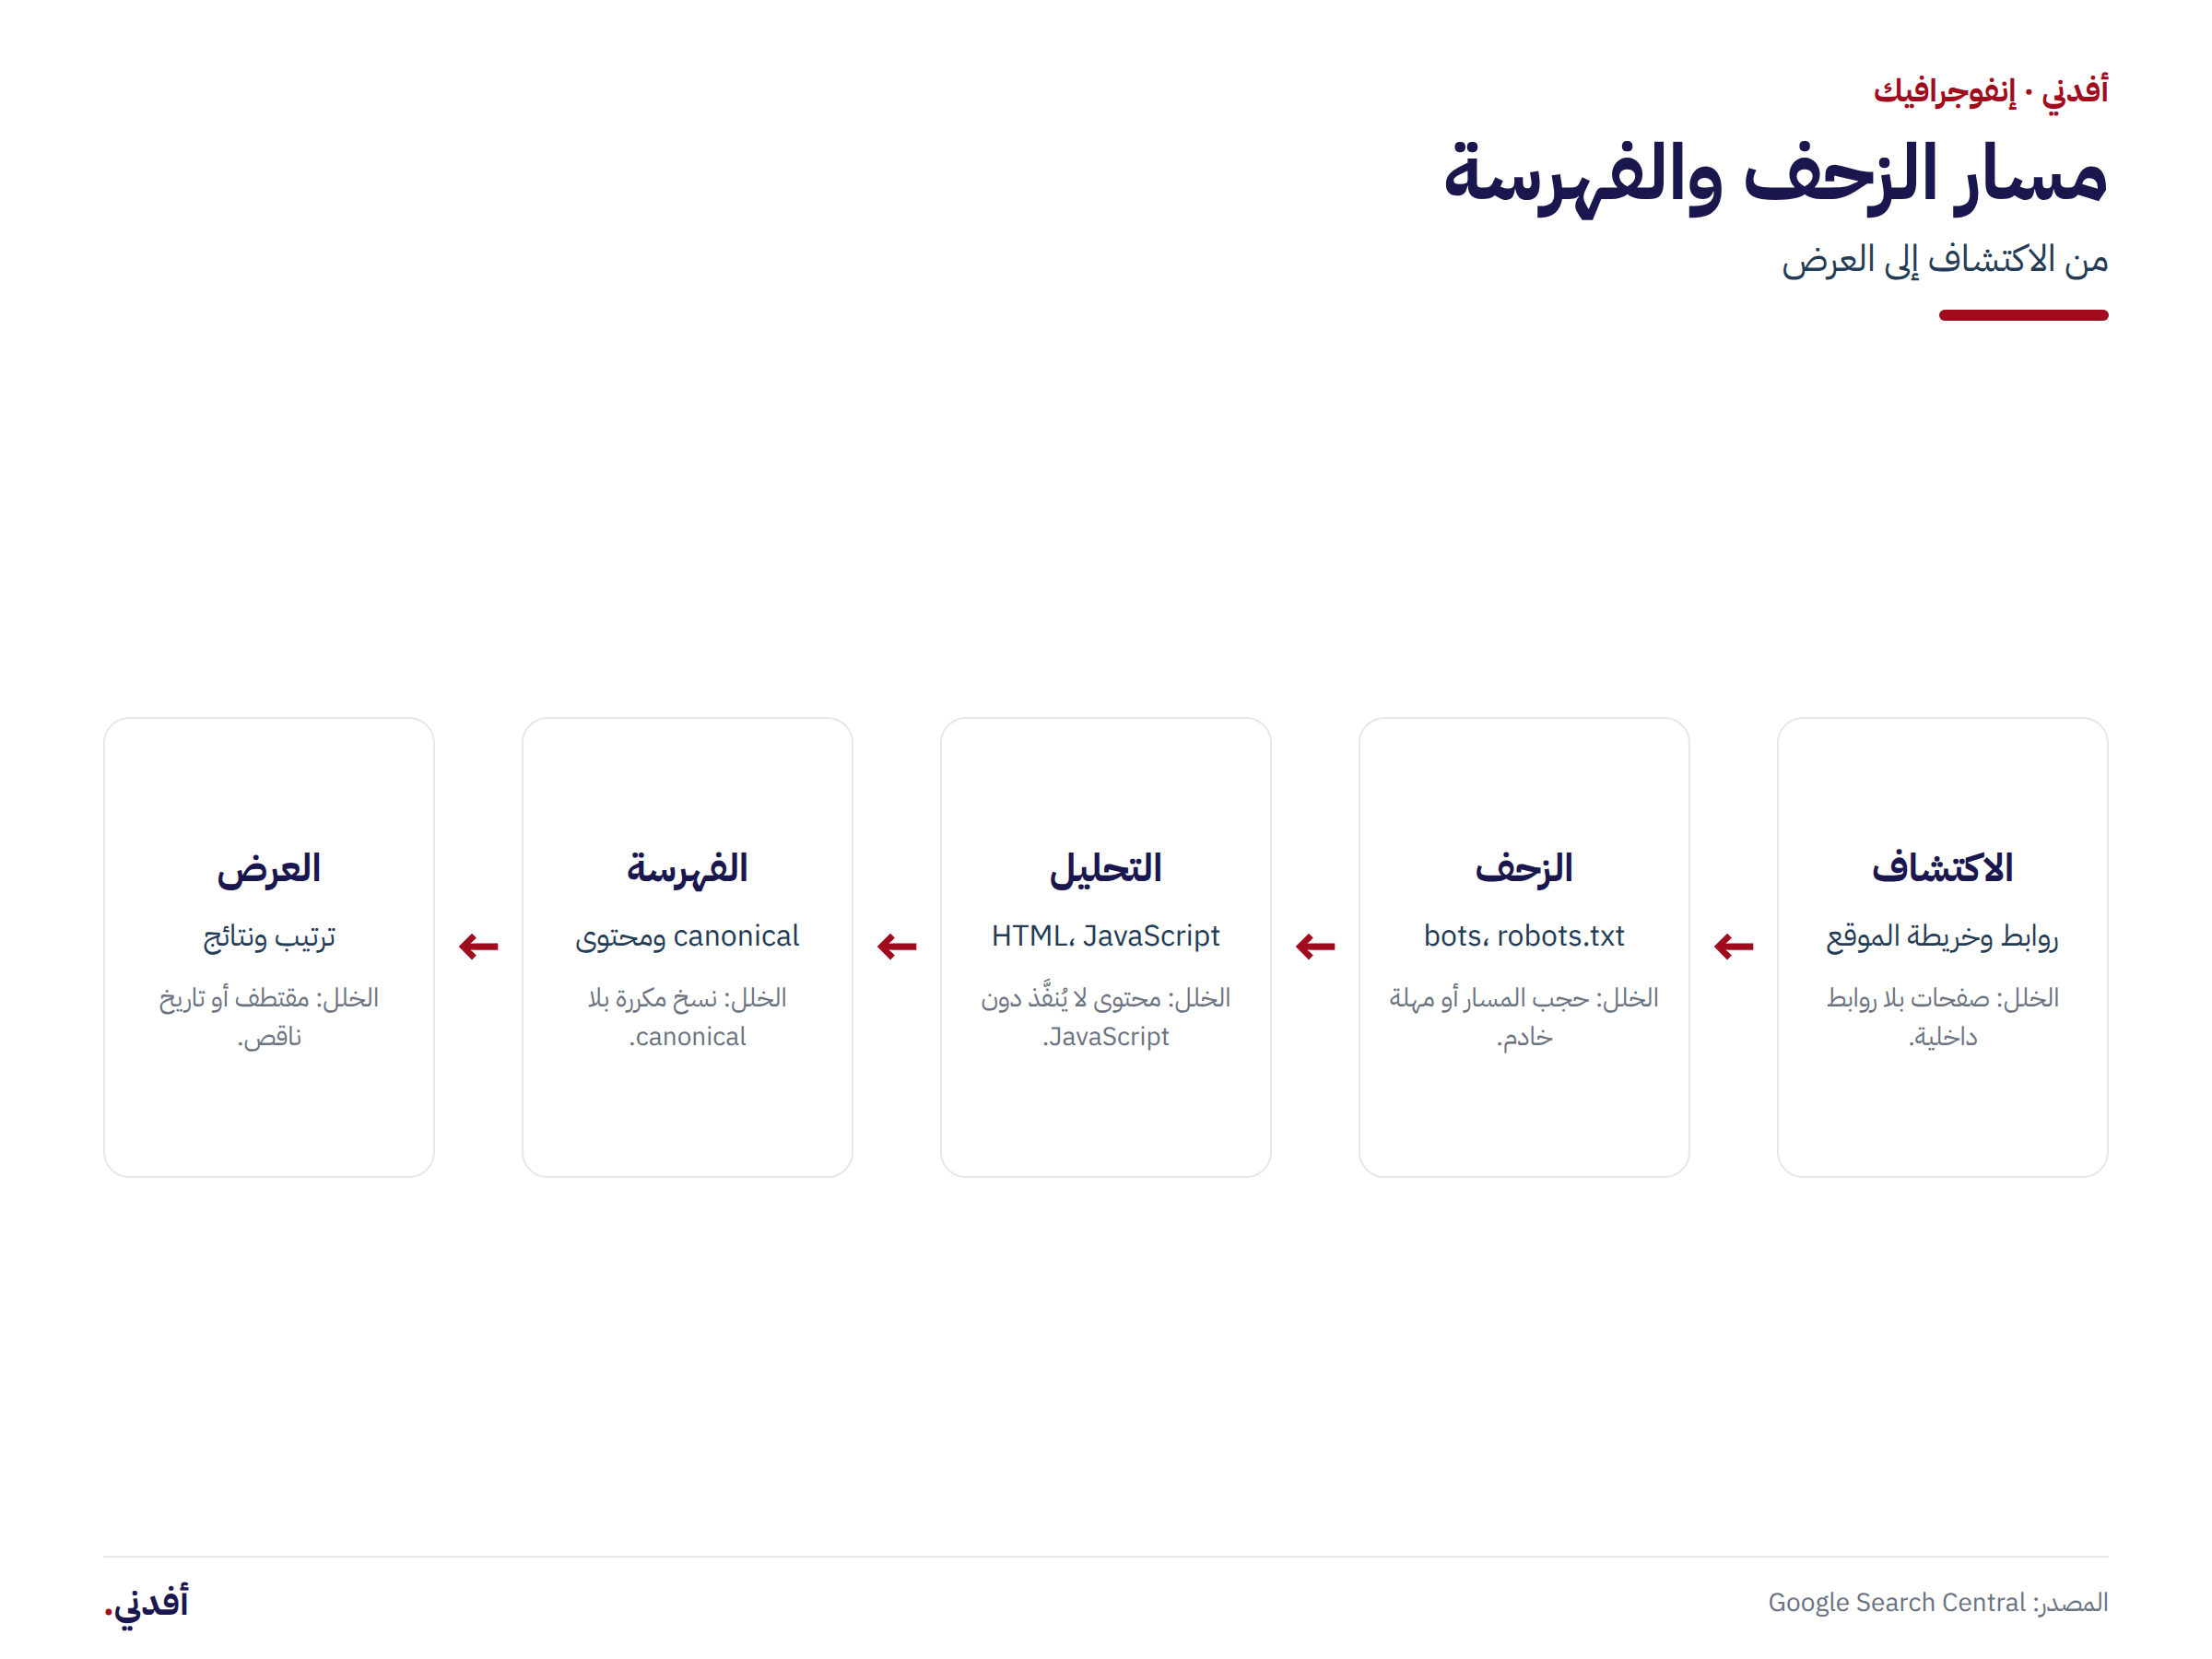
كيف يعمل الزحف والفهرسة؟ خمس مراحل
- الاكتشاف (Discovery): يجد المحرك العنوان عبر رابط داخلي أو خارجي، أو عبر خريطة الموقع.
- طلب الصفحة (Crawling): يحلّ اسم النطاق عبر نظام أسماء النطاقات (DNS)، ثم يطلب الصفحة من الخادم.
- العرض (Rendering): ينفّذ تعليمات JavaScript عند الحاجة ليرى المحتوى كما يراه المتصفح.
- الفهرسة (Indexing): يحلل النص والوسوم، ويختار العنوان الأساسي، ويحفظ الصفحة في الفهرس.
- العرض في النتائج (Serving): يقرر أي صفحة تُعرض لأي استعلام، ويبني المقتطف.
وتبدأ الرحلة قبل كل ذلك من اسم النطاق (Domain) وسجلاته. فخطأ في DNS أو شهادة منتهية يجعل الطلب يفشل قبل أن يصل إلى أي محتوى، ويظهر في Search Console كخطأ في الزحف لا كمشكلة في المحتوى. ويرتّب الشكل 1 المسار في خمس مراحل.
أدوات التحكم في الزحف والفهرسة
ملف robots.txt
ملف نصي في جذر الموقع يخبر الزواحف بما يُسمح بطلبه وما يُمنع. وهو معيار موثق في RFC 9309 منذ سبتمبر 2022، وتلتزم به Google وغيرها. تذكّر أنه يتحكم في الزحف فقط، ولا يمنع الفهرسة إذا كانت الصفحة معروفة من رابط خارجي أو مفهرسة سابقًا.
وسم noindex
وسم في رأس الصفحة يطلب من المحرك عدم إدراجها في الفهرس. وهو الأداة الصحيحة لإخفاء صفحة من النتائج، بشرط ألا يمنع robots.txt الوصول إليها، وإلا لن يقرأ المحرك الوسم أصلًا. وإزالة الوسم لا تعيد الفهرسة فورًا، بل تحتاج إلى وقت وزحف جديد.
الرابط الأساسي (Canonical)
عندما تتعدد نسخ الصفحة، يحدد الوسم النسخة الممثلة لها. تتعامل معه Google بوصفه إشارة توجيهية، وقد تختار عنوانًا آخر إن تناقضت الإشارات. ولهذا ينبغي أن يتفق الوسم مع خريطة الموقع والروابط الداخلية والتحويلات.
خريطة الموقع (Sitemap)
ملف يسرد العناوين التي تريد فهرستها، ويساعد على الاكتشاف السريع، خصوصًا في المواقع الجديدة أو الكبيرة. وهو إشارة اقتراح لا أمر، ولا يضمن الفهرسة. حدّثه عند إضافة صفحات أو حذفها، واحذف منه العناوين المحجوبة أو المحوّلة.
الروابط الداخلية ورموز الحالة
الروابط الداخلية هي طريق الاكتشاف الأساسي. أما رموز الحالة فتحدد مصير الطلب: 200 للصفحة السليمة، و301 للتحويل الدائم، و404 للمفقود، و410 للمحذوف نهائيًا، و5xx لأخطاء الخادم. وسلاسل التحويل الطويلة تضعف تجربة الزائر وتستهلك جهد الزحف.
robots.txt أم noindex: أيهما أستخدم؟
السؤال يتكرر لأن الأداة الخاطئة تُنتج أثرًا معاكسًا. استخدم robots.txt عندما تريد منع الزحف إلى مسارات لا قيمة لها، مثل صفحات البحث الداخلي أو مسارات الفلاتر. واستخدم noindex عندما تريد إخفاء صفحة من النتائج مع السماح بقراءتها. والجمع بينهما خطأ شائع: حجب الصفحة في الملف يمنع المحرك من رؤية وسم الإخفاء.
كيف تشخّص المشكلة في Search Console؟
- افتح تقرير «فهرسة الصفحات»، واقرأ أسباب الاستبعاد مجمعة لا فردية.
- اختبر عنوانًا بعينه بأداة فحص العنوان، وراجع سبب عدم الفهرسة إن وُجد.
- راجع تقرير خرائط الموقع للتأكد من القراءة الناجحة وعدد العناوين المكتشفة.
- افحص
robots.txtمن الأداة نفسها، وتأكد من عدم حجب مسارات مهمة. - قارن إحصاءات الزحف قبل التغيير وبعده، لا في اليوم نفسه.
أخطاء شائعة تمنع الفهرسة
- noindex بالخطأ: وسم بقي من بيئة الاختبار ونُشر إلى الإنتاج.
- حجب ملفات التنسيق: منع CSS وJavaScript يجعل الصفحة تبدو فارغة.
- canonical خاطئ: جميع الصفحات تشير إلى عنوان واحد.
- خريطة موقع قديمة: تعرض عناوين محذوفة أو محوّلة.
- محتوى يعتمد على النقر: أقسام لا تظهر إلا بعد تفاعل لا ينفذه الزاحف.
- تكرار بلا توحيد: نسخ متعددة بالمعاملات نفسها تتنافس فيما بينها.
حدود الزحف والفهرسة
الفهرسة ليست مكافأة على الجودة، بل قرار تشغيلي يمكن أن يتأخر أو يُقيّد. وقد تُفهرس صفحة ضعيفة، ولا تُفهرس صفحة جيدة لأن الموقع جديد أو لأن إشاراته ضعيفة. لا تنتظر من الفهرسة أن تحل مشكلة محتوى، ولا من المحتوى أن يحل مشكلة حجب. راجع تحسين محركات البحث داخل الصفحة بعد التأكد من الفهرسة، لأن الترتيب يبدأ من هناك.
ولاستكمال الصورة في بنية الظهور العضوي، راجع أيضًا شرح تحسين محركات البحث التقني والمحتوى المحوري.
أسئلة شائعة عن الزحف والفهرسة
ما الفرق بين الزحف والفهرسة؟
الزحف هو طلب الصفحة وقراءتها، والفهرسة هي حفظها في فهرس المحرك بعد التحليل. قد تُزحف صفحة ولا تُفهرس، وقد تُفهرس ثم تُستبعد عند تغير المحتوى أو الإشارات. الفصل بينهما ضروري عند التشخيص، لأن كل مرحلة لها أسبابها وأدواتها.
هل منع الزحف في robots.txt يمنع الظهور في البحث؟
لا يضمن ذلك. الملف يمنع الزحف فقط، وقد تظهر الصفحة إذا كانت مفهرسة سابقًا أو وصل إليها المحرك من رابط خارجي. لإخفاء الصفحة من النتائج استخدم noindex مع السماح بالزحف، ثم تحقق من زوالها تدريجيًا بعد إعادة الزحف.
كم يستغرق ظهور الصفحة في البحث بعد نشرها؟
لا توجد مدة مضمونة. قد تظهر خلال ساعات، وقد تحتاج أسابيع بحسب قوة الموقع وبنية الروابط وحجم المنافسة. ساعد الاكتشاف برابط داخلي وخريطة موقع محدثة، وتابع حالة العنوان في Search Console بدل التخمين.
هل خريطة الموقع تضمن الفهرسة؟
لا. خريطة الموقع إشارة اقتراح تساعد الاكتشاف، لكن المحرك يقرر الفهرسة بحسب جودة الصفحة وإشاراتها. وجود العنوان في الخريطة لا يعني إدراجه، وغيابه لا يمنع الاكتشاف عبر الروابط. الأهم أن تكون الخريطة صحيحة ومحدثة.
لماذا تُفهرس صفحة ولا تظهر في النتائج؟
الفهرسة تضع الصفحة ضمن المرشحين، أما الظهور فيتطلب أن تكون مناسبة للاستعلام وأفضل من البدائل. قد تكون الصفحة مفهرسة لكنها ضعيفة الصلة، أو تنافسها صفحة أخرى في موقعك، أو لا يبحث أحد بالكلمات التي تستهدفها. راجع الصلة والمحتوى بعد التأكد من الفهرسة.
المصادر
- Google’s crawlers and fetchers — Google Search Central، آخر تحديث 12 يونيو 2026.
- Robots.txt introduction and guide — Google Search Central، آخر تحديث 10 ديسمبر 2025.
- Sitemaps overview — Google Search Central، آخر تحديث 10 ديسمبر 2025.
- How to specify a canonical URL — Google Search Central، آخر تحديث 10 يوليو 2026.
- RFC 9309: Robots Exclusion Protocol — IETF، سبتمبر 2022.