
خلاصة سريعة: التعلم المعزز (Reinforcement Learning) أسلوب في تعلم الآلة يتعلم فيه النظام من التجربة: ينفذ إجراءً في بيئة، ويقيس نتيجته بمكافأة، ثم يعدّل سياسته ليزيد مجموع المكافآت على المدى الطويل. لا يحتاج إلى بيانات مصنفة سلفًا، بل إلى بيئة وقاعدة تقييم واضحة. قوته في القرارات المتتابعة، وحدّه في بطء التدريب وهشاشة إشارة المكافأة.
ما هو التعلم المعزز؟
التعلم المعزز (Reinforcement Learning) فرع من فروع تعلم الآلة يدرّب وكيلًا (Agent) على اتخاذ قرارات متتابعة داخل بيئة (Environment). يلاحظ الوكيل حالة البيئة، ويختار إجراءً من بين إجراءات متاحة، فتنتقل البيئة إلى حالة جديدة، ويعود إليه رقم يُسمى مكافأة (Reward). ولا يخبره أحد بالإجراء الصحيح مسبقًا؛ يستنتج الصواب من أثر فعله، ويعدّل سلوكه خلال محاولات متكررة.
ويُوصف سلوك الوكيل بالسياسة (Policy)، وهي دالة تربط الحالة بالإجراء، وقد تكون جدولًا صريحًا أو شبكة عصبية. وإلى جانب السياسة تُستخدم دالة القيمة (Value Function) لتقدير العائد المتوقع من حالة أو من إجراء، وهي التي تسمح للوكيل بالتمييز بين مكافأة صغيرة الآن ومكافأة أكبر بعد خطوات عدة. وتنقسم الخوارزميات إلى عائلات: منها ما يتعلم القيمة مثل Q-Learning، ومنها ما يتعلم السياسة مباشرة مثل PPO، ومنها ما يجمع بين الاثنين. وتضيف الأساليب القائمة على النموذج توقعًا لنتيجة الإجراء قبل تنفيذه، وهي أكثر كفاءة في عدد المحاولات، غير أنها تهتز إذا أخطأ النموذج الداخلي في وصف البيئة.
لماذا يختلف التعلم المعزز عن التعلم بالإشراف؟
في التعلم بالإشراف يتلقى النموذج مدخلًا وجوابًا صحيحًا، فيقلل الفارق بين توقعه والجواب. أما في التعلم المعزز فلا يوجد جواب صحيح لكل خطوة، بل إشارة متأخرة قد تكون متناثرة، وقد يتغير معنى الإجراء بحسب ما قبله وما بعده. ولهذا تُقاس الجودة بالعائد التراكمي لا بدقة التصنيف وحدها.
| المعيار | التعلم بالإشراف | التعلم المعزز |
|---|---|---|
| مصدر الإشارة | جواب صحيح لكل مثال | مكافأة متأخرة قد تكون متناثرة |
| توقيت التغذية الراجعة | فوري بعد كل مثال | بعد خطوات أو في نهاية الحلقة |
| البيانات | مجموعة ثابتة أُعدت سلفًا | تتولد بالتجربة وتتغير بتغير السلوك |
| الهدف | تقليل خطأ التنبؤ | تعظيم العائد التراكمي |
| الخطر الأساسي | حفظ الأنماط دون فهم | استغلال ثغرة في إشارة المكافأة |
كيف يعمل التعلم المعزز؟ المكافأة والسياسة والبيئة
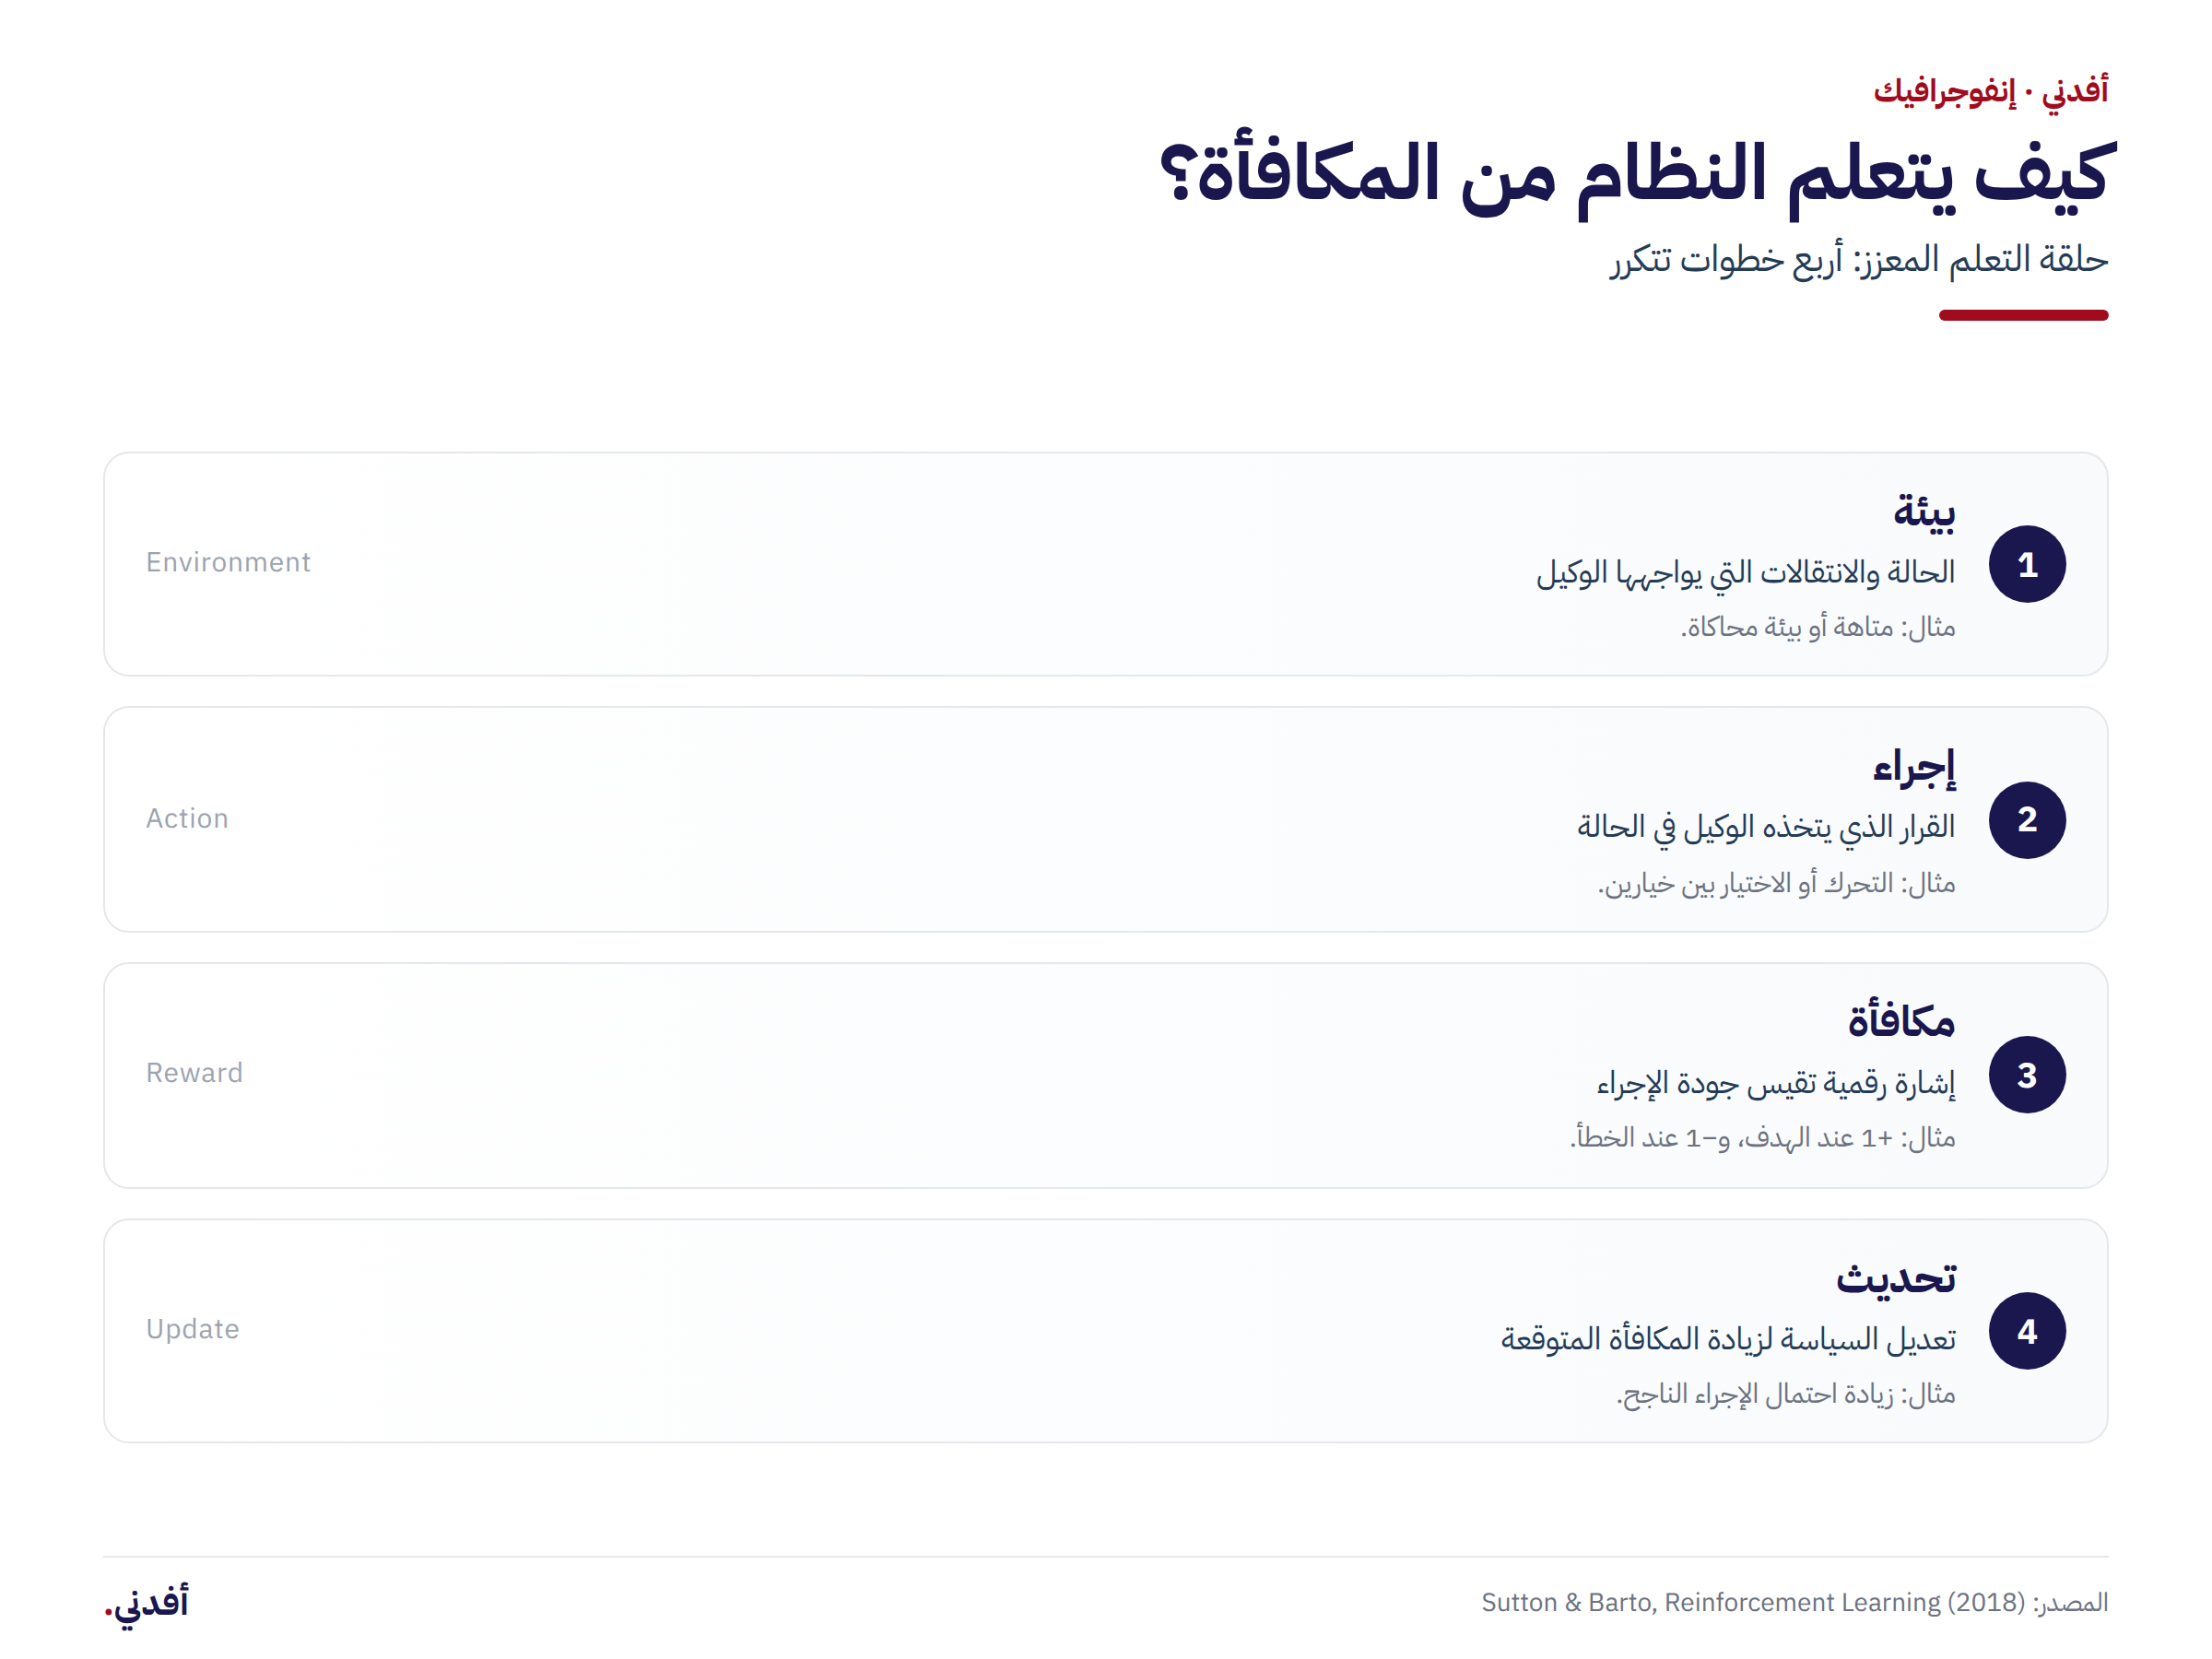
تتكرر الحلقة في كل خطوة زمنية، وتتكون من 5 عناصر مترابطة:
- الوكيل: الجزء الذي يتخذ القرار، ويحمل السياسة التي تُحدَّث بعد كل تجربة.
- البيئة: كل ما يحيط بالوكيل ويتفاعل معه، من محاكاة فيزيائية إلى واجهة برمجية إلى سوق إلكتروني.
- الحالة والإجراء: وصف لما يراه الوكيل الآن، وخيار من مجموعة الخيارات المتاحة له.
- المكافأة: رقم تعيده البيئة بعد الإجراء، وهو الترجمة الوحيدة لما نريده فعلًا. فإن كانت الإشارة غامضة أو قابلة للتحايل تعلّم الوكيل السلوك الخطأ بثقة.
- السياسة: القاعدة التي تحول الحالة إلى إجراء، وهي الناتج النهائي الذي نحتفظ به بعد التدريب.
ويُضاف إلى ذلك معامل الخصم (Discount Factor) لموازنة المكافأة القريبة بالمكافأة البعيدة، ومعدل التعلم الذي يحدد حجم التعديل في كل تحديث، وشرط إنهاء الحلقة الذي يفصل المحاولة الواحدة عن غيرها. وضبط هذه القيم جزء من التصميم لا تفصيل تنفيذي؛ فمعامل خصم قريب من الواحد يجعل الوكيل ينتظر مكافأة بعيدة قد لا تتحقق، ومعامل قريب من الصفر يجعله انتهازيًا قصير النظر. ويلخّص الشكل 1 هذه الحلقة في أربع خطوات متكررة.
ما معضلة الاستكشاف والاستغلال؟
الاستكشاف (Exploration) يعني تجربة إجراءات لم يختبرها الوكيل من قبل لمعرفة عائدها، والاستغلال (Exploitation) يعني اختيار أفضل ما يعرفه الآن. والمشكلة أن كلاهما يستهلك فرصة: فالتجربة قد تكلف مكافأة كان يمكن كسبها، والبقاء على المعلوم يمنع اكتشاف حل أفضل. ويظهر الأثر عمليًا في أبسط صورة: وكيل يفضّل زرًا واحدًا في واجهة، ويستمر في اختياره لأن أول تجربة أعطته نتيجة مقبولة، فلا يكتشف أن الزر الآخر يحقق ضعف النتيجة.
وتعالج الخوارزميات هذه المعضلة بموازنة صريحة: قاعدة إبسلون الجشعة (Epsilon-Greedy) تختار إجراءً عشوائيًا بنسبة صغيرة، وطريقة العينات من توزيع احتمالي توزع التجربة بحسب الثقة، ومعيار الثقة العلوي (UCB) يفضل الإجراءات التي لم تُجرَّب كثيرًا. والقاعدة العملية أن الاستكشاف المفرط يبطئ التعلم، والاستغلال المفرط يحبس النظام في أول حل مقبول.
أين يُستخدم التعلم المعزز عمليًا؟
يظهر التعلم المعزز حيث يكون القرار متتابعًا والنتيجة متأخرة، ومن أبرز مجالاته:
- الألعاب: بلغ النظام AlphaGo مستوى متقدمًا في لعبة Go عام 2016 بعد تدريب جمع بين التعلم المعزز والبحث الشجري، وأظهر أن الوكيل قد يكتشف خططًا لم يفكر فيها الإنسان.
- الروبوتات: تتعلم الذراع كيف تلتقط جسمًا، وتتعلم القدم كيف تحافظ على توازنها، ثم يُنقل السلوك من المحاكاة إلى الجهاز الحقيقي بعد معالجة فجوة الواقع.
- إدارة الموارد: نشرت DeepMind عام 2016 تجربة على تبريد مراكز بيانات Google، وعدّل الوكيل فيها إعدادات التبريد لخفض استهلاك الطاقة.
- التوصيات والترتيب: تختار الأنظمة بين بدائل العرض في تجارب متتابعة، وتوازن بين استكشاف محتوى جديد واستغلال ما ينجح.
- تدريب النماذج اللغوية: يُستخدم في مرحلة التحسين الأخيرة التي تجعل الإجابة أقرب إلى تفضيل القارئ، وهي موضوع الفقرة التالية.
كيف يدخل التعلم المعزز في تدريب نماذج اللغة؟
يُستخدم التعلم المعزز في المرحلة الأخيرة من تدريب نماذج اللغة الكبيرة ضمن أسلوب يُعرف بالتعلم المعزز من التغذية الراجعة البشرية (RLHF). يُدرَّب أولًا نموذج مكافأة على مقارنات بشرية بين إجابتين، ثم يُحسَّن النموذج اللغوي بهذا النموذج عبر خوارزمية مثل PPO. ووصفت ورقة InstructGPT عام 2022 هذه الخطوات، وأظهرت أن نموذجًا أصغر يفضّله المقيمون على نموذج أكبر لم يمر بها.
والخطر هنا واضح: النموذج يتعلم إرضاء نموذج المكافأة لا إرضاء القارئ، فيبالغ في الإطالة أو المجاملة أو الإجابة الحذرة. ولهذا تُضاف قيود صريحة على الطول والأسلوب، وتُراجع عينات عشوائية، ويُقارن الناتج بمرجع بشري. وهذا ما يفسر أيضًا لجوء بعض الفرق إلى التحسين المباشر من التفضيلات (DPO) بدلًا من حلقة PPO الكاملة، لأنه أبسط في التنفيذ وأقل حساسية لضبط المعاملات. ويبقى التعلم العميق أساس هذه النماذج؛ فالتعلم المعزز يضيف طبقة توجيه للسلوك، ولا يستبدل قدرة النموذج على تمثيل اللغة.
ما حدوده وأوجه فشله؟
لا يفشل التعلم المعزز لأنه بطيء فقط، بل لأن إشارة التقييم قد تكون خاطئة أو ناقصة. وأكثر الأوجه تكرارًا:
- كفاءة العينات: يحتاج الوكيل إلى محاولات كثيرة، وقد تكون المحاولة مكلفة أو خطرة في العالم الحقيقي، فيُدرَّب في محاكاة أولًا.
- اختراق المكافأة (Reward Hacking): يجد الوكيل ثغرة تحقق الرقم المطلوب دون أداء المهمة، مثل لعبة تكرر حركة صغيرة لكسب نقاط بدلًا من إتمام المستوى.
- فجوة المحاكاة إلى الواقع: ينجح الوكيل في بيئة منظمة ثم يتعثر في الواقع بسبب ضجيج أو تأخير أو تفاصيل لم تدخل في النموذج.
- عدم الاستقرار: تحديث صغير في السياسة قد يقلب الأداء، فيحتاج التدريب إلى تثبيت ومراقبة ومقارنة بخط أساس ثابت.
- السلامة والصلاحيات: وكيل يتصرف في نظام حقيقي قد ينفذ إجراءً غير قابل للتراجع، فلا بد من حدود ونقاط موافقة بشرية.
- صعوبة التقييم: لا يكفي متوسط المكافأة للحكم؛ فقد يتحسن المتوسط ويسوء أسوأ سيناريو، وهو ما يهم في التطبيقات الحساسة.
متى تختار التعلم المعزز ومتى تتجنبه؟
اختره حين يكون القرار متتابعًا، وتكون النتيجة متأخرة، ولا تتوفر أمثلة مصنفة لما ينبغي فعله. وتجنبه حين تكفي قاعدة ثابتة أو نموذج إشراف؛ فالنظام القائم على قواعد واضحة أرخص وأسهل في التفسير والاختبار. وإذا كان القرار منفردًا بلا أثر لاحق، فلا حاجة إلى حلقة تعلم أصلًا.
أسئلة شائعة
ما هو التعلم المعزز ببساطة؟
هو أسلوب تدريب يتعلم فيه النظام من التجربة: ينفذ إجراءً، ويحصل على مكافأة، ثم يعدل سلوكه ليزيد مجموع المكافآت. لا يبدأ ببيانات مصنفة، بل ببيئة وقاعدة تقييم، ويحتاج إلى محاولات كثيرة قبل أن يستقر أداؤه.
ما الفرق بين التعلم المعزز والتعلم بالإشراف؟
التعلم بالإشراف يعطي النموذج جوابًا صحيحًا لكل مثال، أما التعلم المعزز فيعطيه مكافأة متأخرة عن نتيجة قراره. ولهذا يقيس الأول دقة التنبؤ، ويقيس الثاني العائد التراكمي للسلوك على مدى خطوات عدة.
ما المقصود بالسياسة في التعلم المعزز؟
السياسة دالة تحدد الإجراء الذي يختاره الوكيل في كل حالة، وقد تكون جدولًا أو شبكة عصبية. وهي الناتج الذي يبقى بعد التدريب، بينما تُستخدم دالة القيمة أثناءه لتقدير العائد المتوقع وتوجيه التحديث.
ما معضلة الاستكشاف والاستغلال؟
الاستكشاف يجرب إجراءات جديدة لمعرفة عائدها، والاستغلال يختار أفضل ما يعرفه الوكيل الآن. والإفراط في الأول يبطئ التعلم، والإفراط في الثاني يحبس النظام في أول حل مقبول، فتحتاج الخوارزمية إلى موازنة بينهما.
هل يتعلم النموذج اللغوي بالتعلم المعزز وحده؟
لا. يبدأ النموذج بتدريب على بيانات واسعة، ثم يمر بمرحلة إشراف، وبعدها يُستخدم التعلم المعزز لتحسين الأسلوب والالتزام بالتعليمات. والتعلم المعزز طبقة توجيه فوق قدرة لغوية موجودة، وليس بديلًا عن بناء النموذج.
المصادر
- AWS، ما هو التعلم المعزز؟ (دليل تقني، اطُّلع عليه في 24 أكتوبر 2026)
- Stanford CS234، Reinforcement Learning (مواد المقرر، اطُّلع عليه في 24 أكتوبر 2026)
- Schulman et al.، Proximal Policy Optimization Algorithms، arXiv، 20 يوليو 2017
- Ouyang et al.، Training language models to follow instructions with human feedback، arXiv، 4 مارس 2022
- IBM، What is reinforcement learning? (اطُّلع عليه في 24 أكتوبر 2026)
صورة الغلاف: Michael Gaylard / Wikimedia Commons، بموجب رخصة CC BY.